
Notizen & Berichte aus der Praxis
Vorträge, Workshops, Konferenzen und Texte aus dem Zentrum — was wir präsentieren, wo, und was wir dabei lernen.
Unsere Studie zu agentischer KI im Podcast «NZZ Akzent»
Der tägliche News-Podcast der NZZ, «NZZ Akzent», widmete unserer Studie zu agentischer KI eine Folge: Technologieredaktorin Gioia da Silva erklärt, wie leicht KI die Massenüberwachung mit Standortdaten macht, und auch Oscar Thees ist in Ausschnitten zu hören.
Beitrag lesen →Weitere Beiträge
-
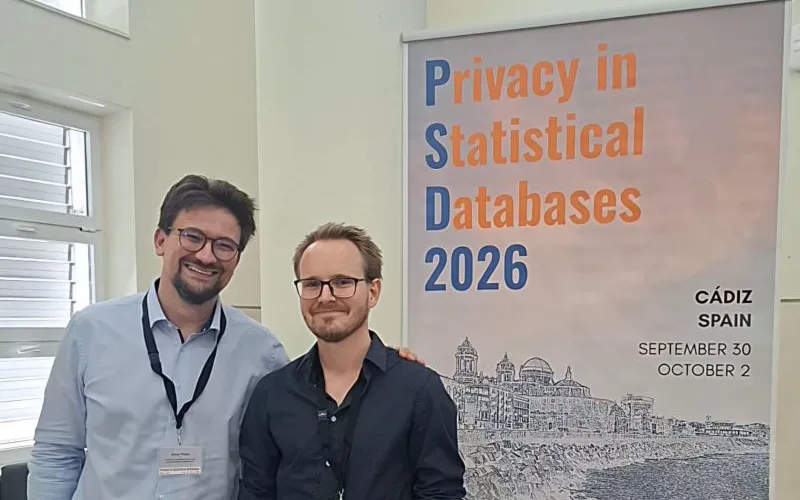
Re-Identifikation mit agentischer KI: Vortrag an der PSD 2026 in Cádiz
An der Konferenz Privacy in Statistical Databases (PSD 2026) in Cádiz stellten Oscar Thees und Roman Müller unsere Studie vor, die zeigt, wie KI-Agenten Personen selbständig aus Bewegungsdaten und öffentlichen Quellen re-identifizieren können.
-
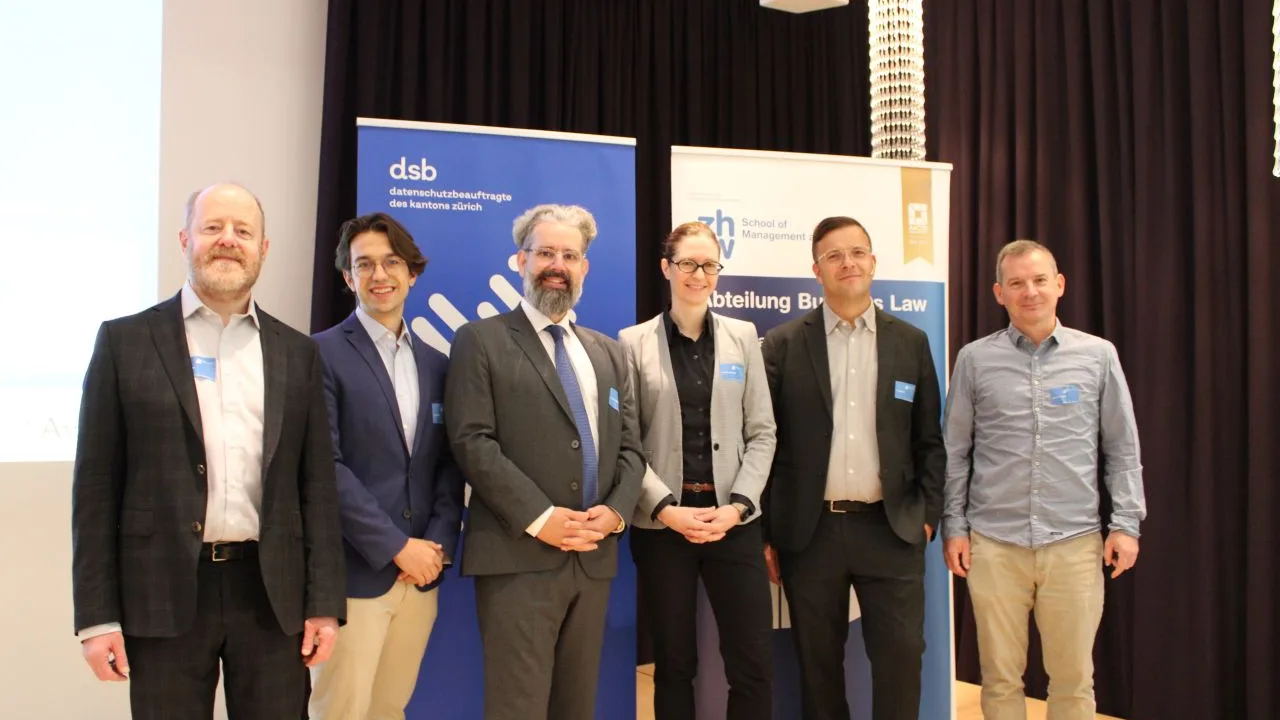
Pseudonymisiert, anonymisiert, synthetisch: unser Vortrag an der Zürcher Datenschutztagung 2026
An der 5. Zürcher Datenschutztagung zu KI in der öffentlichen Verwaltung sprach Matthias Templ über Pseudonymisierung, Anonymisierung und synthetische Daten: was bei KI wirklich funktioniert. Das Interesse war so gross, dass es sogar eine Warteliste gab.
-
Keynote an den Österreichischen Statistiktagen 2026 in Wien: Offenlegungsszenarien, Angreiferkosten und agentische KI
An den Österreichischen Statistiktagen 2026 in Wien hielt Matthias Templ die Keynote in der Session zu innovativen Methoden der amtlichen Statistik: Offenlegungsrisiko gehört zu einem Szenario, jedes Szenario hat einen Preis, und agentische KI hat diesen Preis auf wenige Dollar pro Person gedrückt. Vor vollem Saal, mit angeregter Diskussion.
-
Unsere Studie zu agentischer KI in der NZZ
Die Neue Zürcher Zeitung berichtete über unsere Studie zu agentischer KI und Bewegungsdaten. Unsere Botschaft: Standortdaten, die ohne Namen verkauft werden, lassen sich mit KI-Agenten mit wenig Aufwand einzelnen Personen zuordnen.
-
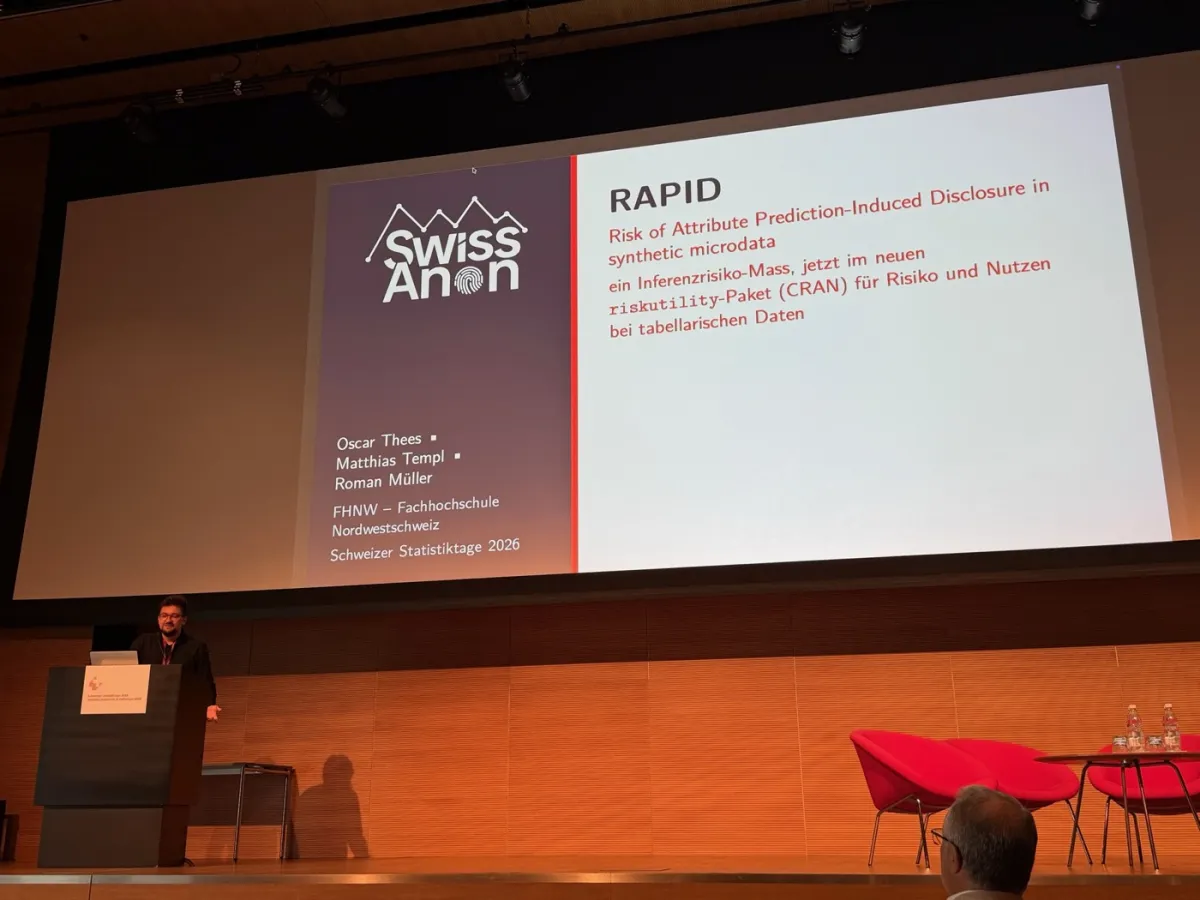
Hochrisiko-Datensätze in synthetischen Daten erkennen: RAPID an den Schweizer Statistiktagen 2026
An den Schweizer Statistiktagen 2026 im Würth Haus Rorschach zeigte Oscar Thees, wie RAPID einzelne Hochrisiko-Datensätze in synthetischen Daten markiert, und fragte, ob Vorhersage ohne Zugriff bereits eine Verletzung der Privatsphäre ist.
-
Ausreisser im Verborgenen: zellweise robuste Imputation an der EcoSta 2026
An der EcoSta 2026 in Kyoto stellte Matthias Templ eine neue Familie zellweise robuster Imputationsmethoden für gemischte stetige und kategoriale Daten vor – versteckte Ausreisser auf Zellebene werden dabei als besondere Art fehlender Werte behandelt –, die nun als drei neue Schätzer im R-Paket VIM verfügbar sind, mit Ergebnissen an einem echten Veterinärdatensatz.
-
RAPID und das neue R-Paket riskutility an der useR! 2026 in Warschau
An der useR! 2026 in Warschau stellte Oscar Thees RAPID vor, unser Mass für das Risiko von Attribut-Inferenz in synthetischen Daten, sowie das neue CRAN-Paket riskutility mit rund 100 Risiko- und Nutzenmassen.
-

SwissAnon am Data Protection Day 2026: vier praktische sdcMicro-Workshops in Zürich
Am Data Protection Day 2026 der Universität Zürich hielt SwissAnon-Leiter Matthias Templ den praxisorientierten Workshop „Working with sdcMicro“ viermal und brachte einen echten Forschungsdatensatz live in der sdcMicro-App von wiedererkennbar zu sicher teilbar.
-
Workshop-Rückblick: Anonymisierung und Pseudonymisierung von Forschungsdaten (Lettland 2026)
Eine zweitägige Online-Schulung zur statistischen Geheimhaltung für das lettische IT-Dienstleistungszentrum für Hochschulen und Wissenschaft (VPC).
-

Workshop-Rückblick: Anonymisierung und synthetische Daten – Methoden, Werkzeuge und Anwendungen
SwissAnon veranstaltete am 26. Januar 2026 einen eintägigen Workshop in Olten, der 19 Fachpersonen aus der Schweiz und aus ganz Europa zu praxisorientiertem Training in Anonymisierungstechniken und Generierung synthetischer Daten anzog.
-

Vortrag zur Anonymisierung von Längsschnitt-Paneldaten an den Statistiktagen 2025 in Genf
Am Schweizer Statistiktreffen (Statistiktage 2025) in Genf präsentierte Oscar Thees Forschungsergebnisse zu den besonderen Datenschutzherausforderungen von Paneldatensätzen, bei denen Verläufe über die Zeit hinweg Personen leichter identifizierbar machen.
-

Eindrücke aus Barcelona: Expert Meeting on Statistical Data Confidentiality 2025
Vom 15.–17. Oktober 2025 nahm SwissAnon am UNECE Expert Meeting on Statistical Data Confidentiality in Barcelona teil, wo Roman Müller Forschungsergebnisse zur Anonymisierung sensibler psychologischer Daten für Open Science präsentierte.
-

DSEmbedded 2.0: Datenschutzkompetenz in der Schweiz stärken
Reto Bürgin ist über die von swissuniversities geförderte Initiative DSEmbedded 2.0 zu SwissAnon gestossen. Das Projekt entwickelt Leitfäden, Tutorials und Beratungsangebote, um Datenschutzwissen an Schweizer Forschungseinrichtungen aufzubauen.
-

Workshop-Ankündigung: Anonymisierung und synthetische Daten – Methoden, Werkzeuge und Anwendungen
SwissAnon kündigt einen praxisorientierten eintägigen Trainingsworkshop zu Datenanonymisierung und Generierung synthetischer Daten an, der am 26. Januar 2026 in Olten stattfindet und von Murat Sariyar und Matthias Templ geleitet wird.
-

Workshop zum Offenlegungsrisiko am Zentrum für Klinische Forschung Zürich
Matthias Templ führte am Zentrum für Klinische Forschung in Zürich einen Workshop zum Offenlegungsrisiko anonymisierter und synthetischer Daten durch und behandelte k-Anonymität, l-Diversität sowie Angreiferszenarien für Forschungsmanagerinnen und Data Stewards.
-

Data Stewards sowie Anonymisierung und Synthetisierung von Daten
Matthias Templ hielt an der Universität Bern einen Vortrag zur Generierung synthetischer Daten und zu Alternativen der Anonymisierung für Data Stewards, mitorganisiert vom Team der Open Science Services der Universität Zürich und dem Data-Stewardship-Programm der Universität Basel.
-

Präsentation unserer Forschung zu synthetischen Daten an der PSD2024 in Antibes
Oscar Thees und Murat Sariyar präsentierten an der Konferenz Privacy for Statistical Databases (PSD2024) in Antibes zwei Arbeiten zur Generierung synthetischer Daten, in denen sie Generatoren für komplexe tabellarische Daten evaluierten und LLMs mit GANs verglichen.
-

Workshop zur Datenanonymisierung an der useR! 2024 in Salzburg
SwissAnon führte an der Konferenz useR! 2024 in Salzburg einen dreistündigen Workshop zu 'Data Anonymization for Open Science' durch, geleitet von Oscar Thees und Jiri Novak und mit den Themen perturbative, nicht-perturbative und synthetische Methoden.
-

Synthetic Data Day 2024
Die Universität Bern, ihre medizinische Fakultät und das Inselspital veranstalteten am 27. Mai 2024 gemeinsam den Synthetic Data Day 2024. Matthias Templ hielt die Keynote über die Bedeutung und die Herausforderungen synthetischer Daten; Murat Sariyar präsentierte einen Vergleich von LLMs und GANs zur Generierung tabellarischer Daten.
-

Jahrestagung der Swiss Clinical Trial Organisation
Matthias Templ hielt an der Plattformtagung Statistics & Methodology der SCTO in Bern einen eingeladenen Vortrag über die Arbeit von SwissAnon zu Anonymisierung und Synthetisierung, mit Fokus auf Membership-Attacken und die besonderen Herausforderungen von Daten aus klinischen Studien.
-
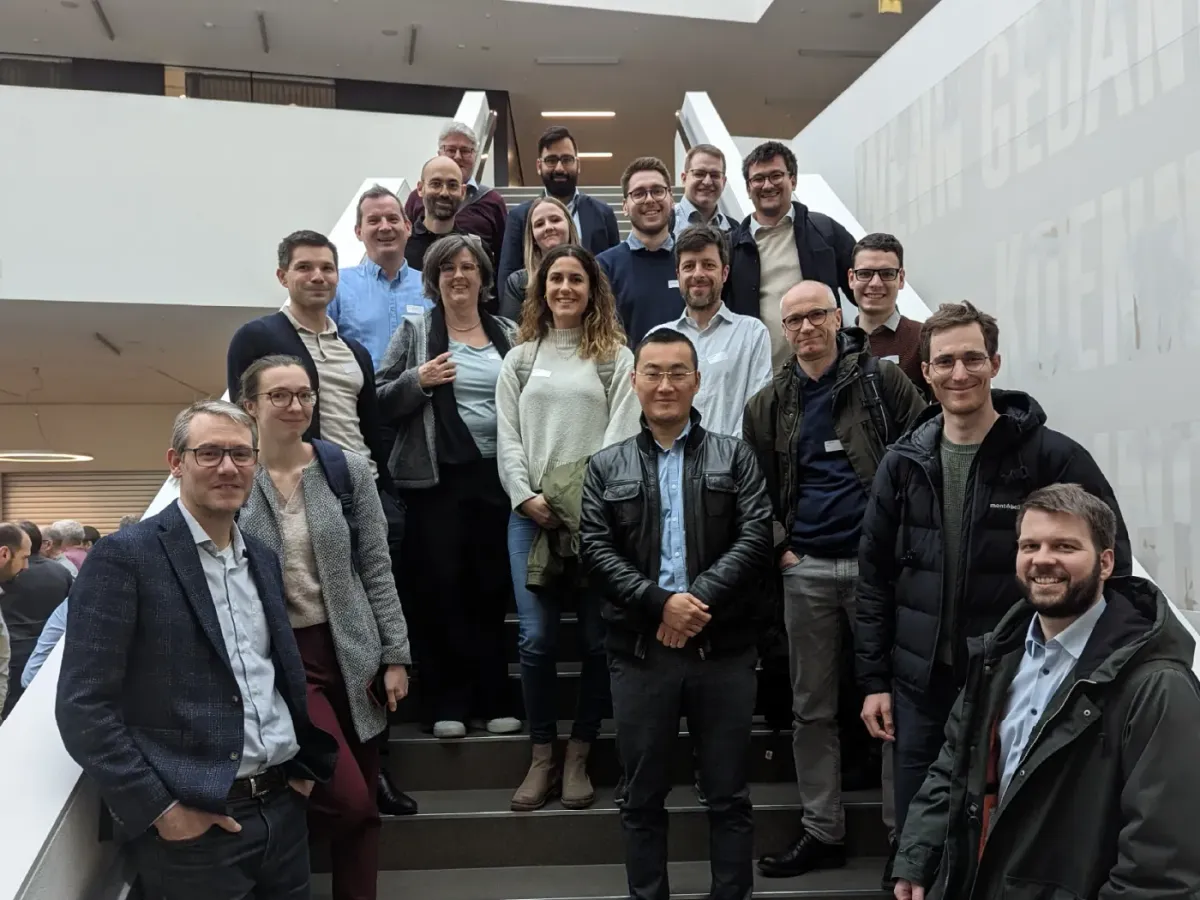
Erkenntnisse vom Stakeholder Day
SwissAnon veranstaltete am 25. März 2024 ein Stakeholder-Treffen in Olten und begrüsste rund 20 Teilnehmende aus Verwaltung, Wissenschaft und Privatwirtschaft, um das SNF Bridge Project vorzustellen und praktische Herausforderungen der Anonymisierung sowie Möglichkeiten der Zusammenarbeit zu erörtern.
-

Workshop für Data Stewards an der Universität Basel
Matthias Templ leitete für das Data-Stewardship-Programm der Universität Basel einen Einführungsworkshop zur Datenanonymisierung quantitativer Daten und behandelte Anonymisierungstechniken, die Bewertung des Offenlegungsrisikos, den Datennutzen sowie Angreiferszenarien.
-
Clarin-Workshop zu sensiblen Daten
An einem Clarin-Workshop zu sensiblen Daten am 22. März 2024 stellte Melanie Röthlisberger Werkzeuge zur Textanonymisierung vor, und Matthias Templ präsentierte sdcMicro als das Referenzpaket für die statistische Geheimhaltung (SDC) in R.