
Disclosure scenarios, attacker cost, and agentic AI.
Offenlegungsszenarien, Angreiferkosten und agentische KI
FHNW School of Business, Institute for Competitiveness and Communication, Olten
SwissAnon – Swiss Data Anonymization Center
Der KI-Angreifer ist Teamarbeit
Oscar Thees
FHNW, Olten · Erstautor der Studie
Roman Müller
FHNW, Olten · Erstautor der Studie
Den Angreifer mit agentischer KI haben wir gemeinsam gebaut und getestet: ein Team von KI-Agenten, das Bewegungsspuren nur mit öffentlichen Quellen einem Namen zuordnet. Oscar Thees und Roman Müller sind die Erstautoren der Studie, zu gleichen Teilen.
Was Sie heute über KI als Angreifer sehen, ist unsere gemeinsame Forschung. Herzlichen Dank, Oscar und Roman.
Wer steht hier vorne?
Geboren in ?
Doktorat und Habilitation an ?
Beratung und Lehre in ?
Arbeitet heute in ?
Vier Merkmale, kein Name. Raten Sie mit.
Wer steht hier vorne?
Geboren in SteyrOberösterreich.
Doktorat und Habilitation an der TU Wien.
Beratung und Lehre in Olomouc.
Arbeitet heute in Olten.
Vier Merkmale. Kein Name. Und Sie wissen, wer hier steht.
Offenlegungsszenarien.
Was ein Angreifer weiss, was er dazulernt – und warum ohne Szenario keine Risikozahl existiert.
Verknüpfung: wie aus vier Merkmalen ein Name wird
Freigegebener Datensatz
| Geburtsort | Hochschule | Beruf | Wert |
|---|---|---|---|
| Wien | Uni Wien | Lehre | … |
| Linz | TU Wien | Professur | 190 360 |
| Graz | TU Graz | Verwaltung | … |
| Salzburg | PLUS | Forschung | … |
Wissen im Saal
Linz · TU Wien · Professur · Name
Drei Merkmale aus dem Datensatz – plus der Name, der dort fehlt.
Genau eine Zeile passt
Damit ist nicht nur die Person bekannt, sondern auch alles andere in dieser Zeile.
Quasi-Identifikator
Merkmal, das für sich harmlos ist – in Kombination aber eindeutig.
Schlüssel
Die Merkmalskombination, über die verknüpft wird.
Äquivalenzklasse
Alle Zeilen mit demselben Schlüssel; ihre Grösse ist die Schlüsselhäufigkeit, hier 1. Gilt das auch in der Bevölkerung? Die nächste Frage.
Zwei Tabellen, eine Verknüpfung
Öffentliches Verzeichnis
| Name | Gemeinde | Beruf | Geschl. |
|---|---|---|---|
| Max Muster | Stadel | Professor | M |
| Anna Bei | Stadel | Ärztin | W |
| Urs Frei | Zürich | Professor | M |
Anonymisierte Erhebung
| Gemeinde | Beruf | Geschl. | Häufigkeit | Einkommen |
|---|---|---|---|---|
| Stadel | Professor | M | 1 | 176 456 |
| Zürich | Professor | M | 18 | … |
Häufigkeit 1
Ein eindeutiger Treffer. Das Einkommen ist offengelegt.
Häufigkeit 18
Kein eindeutiger Treffer: 18 Personen teilen diese Kombination.
20 Dollar für ein Wählerverzeichnis
- Massachusetts gab in den 1990er-Jahren Krankenversicherungsdaten der öffentlich Bediensteten zu Forschungszwecken frei – ohne Namen und Adressen.
- Latanya Sweeney kaufte für rund 20 $ das Wählerverzeichnis von Cambridge.
- Gemeinsame Merkmale: Postleitzahl, Geburtsdatum, Geschlecht. Damit fand sie die Krankenakte des amtierenden Gouverneurs – und schickte sie ihm zu.
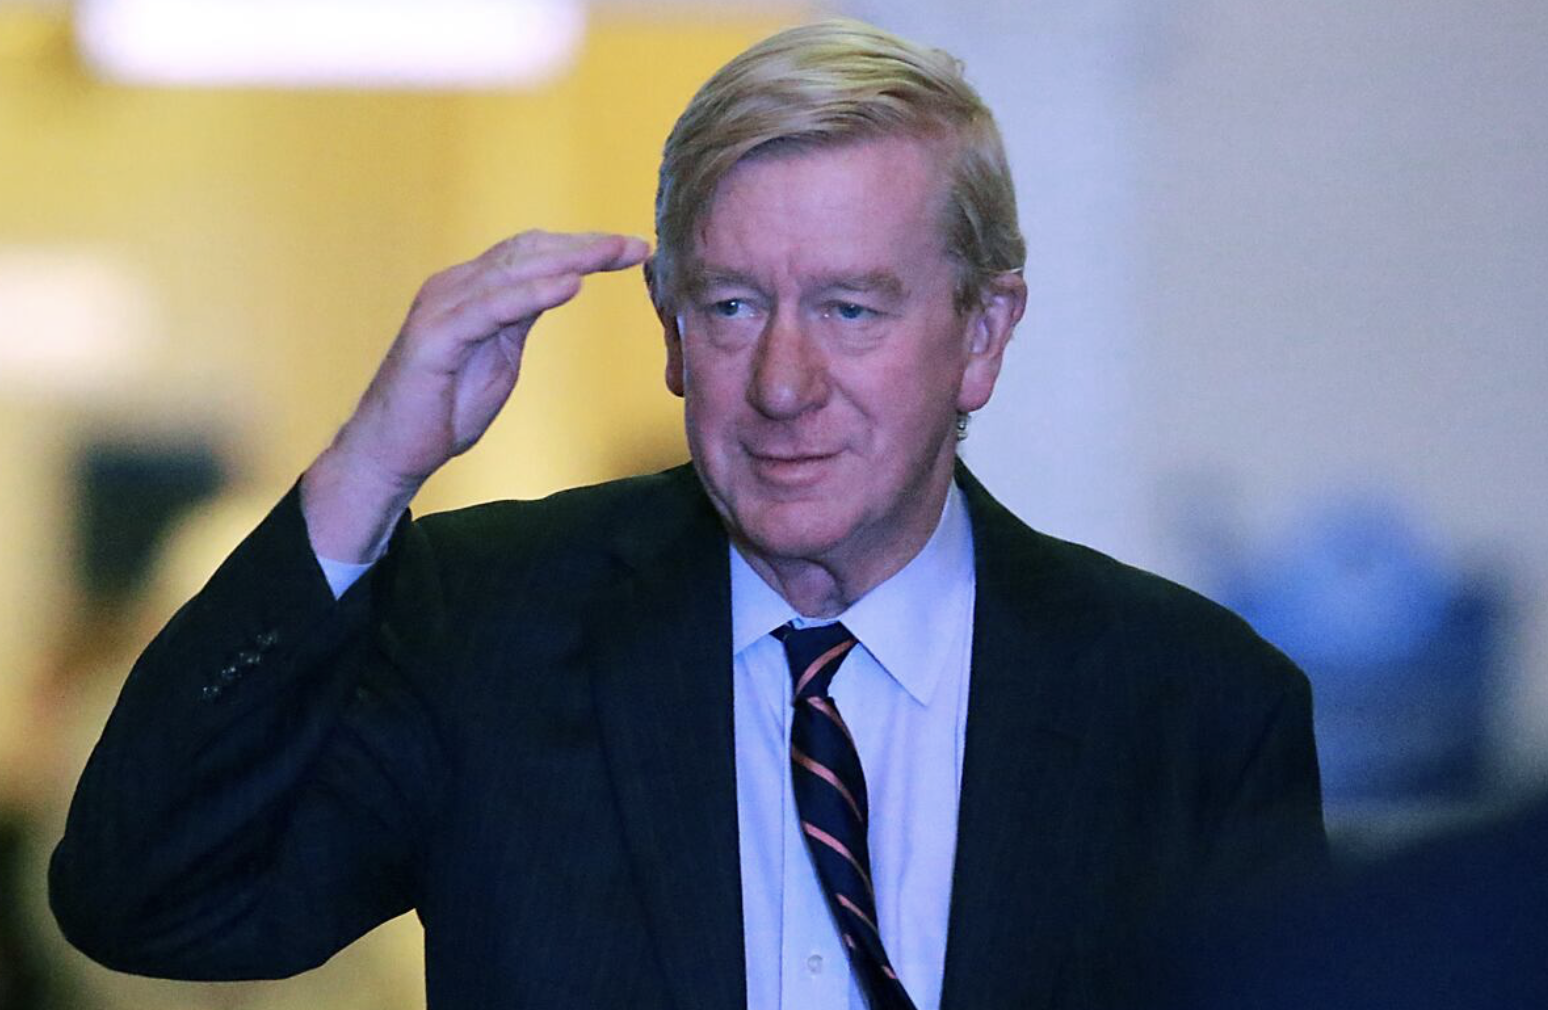
William Weld, 1991–1997 Gouverneur von Massachusetts – der Patient in Sweeneys Beispiel.
Und in der Bevölkerung?
Postleitzahl, Geburtsdatum und Geschlecht machen einen Grossteil der US-Bevölkerung eindeutig.
Sweeney (2000) rechnet 87 %, eine Nachrechnung auf Zensusdaten (Golle 2006) 61 bis 63 %. Die Grössenordnung ist unbestritten, die exakte Zahl nicht.
Daten ohne Namen sind noch keine anonymen Daten.
Vier Arten der Offenlegung
| Person | Alter | Geschlecht | Region | Lernstörung | Prüfungsangst |
|---|---|---|---|---|---|
| P1 | 10–19 | weiblich | Huntington | nein | 9 |
| P5 | 30–39 | männlich | Edmond | ja | 5 |
| P6 | 30–39 | männlich | Alkol | ja | 3 |
| P7 | 50–59 | weiblich | Jesse | nein | 2 |
| P8 | 50–59 | weiblich | Jesse | ja | 3 |
Identität
«Sally, 18, weiblich, hat
teilgenommen.»
Genau eine Zeile passt – alle ihre Antworten sind bekannt.
Attribut
«Tom, 34, männlich.»
P5 oder P6 – welche Zeile er ist, bleibt unbestimmt. Beide tragen
denselben Wert, damit ist sein Merkmal offengelegt.
Mitgliedschaft
«Ist Nicole überhaupt in der
Erhebung?»
Sensibel, wenn schon die Teilnahme etwas verrät, etwa bei einer
Klinikstichprobe. Aus drei Zeilen folgt ihre Teilnahme erst, wenn in der
Bevölkerung niemand sonst passt.
Inferenz
«Alter und Geschlecht sagen
Prüfungsangst voraus.»
Das Modell trifft Aussagen über Personen, die
gar nicht in den Daten sind.
Ohne Szenario keine Risikozahl
Der neugierige Nachbar
Kennt eine Person und ihre Merkmale. Sucht deren Zeile.
Wenig Wissen, hohe Motivation. Das typische Szenario für offene Daten.
Das Archiv
Verfügt über eine ganze externe Datei und sucht systematisch nach Treffern.
Viel Wissen, viele Ziele. Das Szenario für Register und kommerzielle Datensätze.
Die Differenz
Stellt einem Abfragesystem zwei fast identische Fragen und liest die Antwort aus der Differenz.
Das Szenario für Tabellen und Auswertungsdienste.
Jede Risikozahl ist eine bedingte Grösse: bedingt auf das Wissen, das man dem Angreifer unterstellt. Bleibt diese Bedingung ungenannt, ist die Zahl weder vergleichbar noch nachprüfbar.
Wenn k-Anonymität nicht genügt
| Alter | Geschlecht | PLZ | Diagnose |
|---|---|---|---|
| 30–39 | männlich | 405** | Grippe |
| 30–39 | männlich | 405** | Bruch |
| 30–39 | männlich | 405** | Grippe |
| 50–59 | weiblich | 412** | Krebs |
| 50–59 | weiblich | 412** | Krebs |
| 50–59 | weiblich | 412** | Krebs |
k-Anonymität: jede Äquivalenzklasse mindestens k Zeilen. Wirksam gegen Identitätsoffenlegung.
Lücke 1 · Homogenität
Wer weiss, dass eine 55-jährige Frau in der unteren Klasse steht, kennt die Diagnose.
Setzt Teilnahmewissen voraus: bei einer Vollerhebung geschenkt, bei einer Stichprobe nicht. l-Diversität verlangt Vielfalt im sensiblen Merkmal.
Lücke 2 · Stichprobe ≠ Bevölkerung
Einmal in der Stichprobe, Gewicht 100: hundert Kandidaten. Gewicht 1: auch im Land einzigartig.
Summe der Einzelrisiken = erwartete Zahl korrekt zugeordneter Zeilen – gleich sehen Sie sie fallen.
Belastbar nur, wenn die Schlüsselvariablen im Stichprobendesign vorkommen – sonst modelliert man sie (Benedetti & Franconi 1998).
Jedes Szenario hat einen Preis
«So viel Aufwand betreibt doch niemand.»
Auf diesem Satz ruht die Praxis der Datenfreigabe. Er heisst faktische Anonymität – und er ist eine ökonomische Behauptung, keine mathematische.
DSGVO, Erwägungsgrund 26
Massgeblich sind alle Mittel, deren Einsatz nach allgemeinem Ermessen wahrscheinlich ist – Kosten und Zeit eingerechnet.
§ 16 Abs. 6 BStatG, Deutschland
Faktisch anonym sind Angaben, die nur «mit unverhältnismässig grossem Aufwand an Zeit, Kosten und Arbeitskraft» zuzuordnen sind.
Beide Texte binden den Schutz an Zeit und Kosten. Gemessen hat ihn bisher niemand. Wir kommen darauf zurück – im letzten Teil, mit Zahlen. Vorher: woran messen wir das Ergebnis?
Risiko und Nutzen.
Je eine Zahl für Risiko und Nutzen genügt nicht.
Die Risiko-Nutzen-Karte
Vier Felder
Oben rechts: brauchbar, aber zu riskant.
Unten links: sicher, aber wertlos.
Oben links: das Schlimmste aus beidem.
Unten rechts: das Ziel.
Anonymisierung ist eine Bewegung auf dieser Karte: vom Original nach links unten – so weit wie nötig, so wenig wie möglich.
Erst nebeneinander sieht man es
| Risiko – klein ist gut | Nutzen – gross ist gut | |||||||||
|---|---|---|---|---|---|---|---|---|---|---|
| Generator | RepU | TCAP | RAPID | MIA | DCR | pMSE | CIProx | Wasserstein | CMD | NoAdultHH |
| synthpop ★ | 0.19 | 0.24 | 0.92 | 1.00 | 0.26 | 0.97 | 0.99 | 1.00 | 0.95 | 0.97 |
| arf | 0.17 | 0.13 | 0.67 | 0.04 | 0.03 | 0.52 | 0.28 | 0.05 | 0.27 | 0.52 |
| MostlyAI ★ | 0.16 | 0.09 | 0.78 | 0.41 | 0.10 | 0.90 | 0.89 | 0.99 | 0.56 | 0.70 |
| simPop ★ | 0.18 | 0.05 | 0.64 | 0.03 | 0.08 | 0.64 | 0.94 | 0.99 | 0.34 | 1.00 |
| GRETEL | 0.11 | 0.06 | 0.62 | 0.77 | 0.05 | 0.34 | 0.96 | 0.97 | 0.65 | 0.49 |
| synthcity | 0.07 | 0.07 | 0.51 | 0.25 | 0.01 | 0.34 | 0.63 | 0.96 | 0.19 | 0.41 |
| SDV_GC | 0.13 | 0.07 | 0.60 | 0.18 | 0.01 | 0.44 | 0.87 | 0.88 | 0.49 | 0.51 |
| SDV_VAE ★ | 0.05 | 0.05 | 0.53 | 0.24 | 0.01 | 0.52 | 0.87 | 0.95 | 0.31 | 0.52 |
| original ★ | 1.00 | 1.00 | 0.95 | 1.00 | 1.00 | 1.00 | 1.00 | 1.00 | 1.00 | 1.00 |
synthpop
Bester Nutzen – und ein Mitgliedschaftsrisiko auf dem Niveau der Originaldaten.
arf
Geringes Mitgliedschafts- und Distanzrisiko – aber ein Inferenzrisiko wie alle anderen und eine Verteilungstreue, die zusammenbricht.
RAPID
Bleibt bei jedem Generator hoch (0,51 bis 0,92). Das Inferenzrisiko überlebt jede Synthese.
Pareto statt Sieger
Die Front ersetzt den Sieger durch eine Auswahl. Wo man auf ihr steht, ist eine Governance-Entscheidung – keine statistische.
Pareto-optimal = Auswahlliste
Kein anderes Verfahren ist gleichzeitig sicherer und nützlicher. Vier von acht bleiben übrig.
Warum die grauen wegfallen
GRETEL etwa: simPop ist sicherer und nützlicher zugleich. Damit ist GRETEL aus dem Rennen.
Der letzte Schritt ist der teuerste
Von synthpop zum Original steigt das Risiko 27-mal stärker als der Nutzen.
Praktisch: Die synthetische Datei kostet rund 2 % Nutzen und nimmt gut die Hälfte des Risikos.
Anonymisieren oder synthetisieren?
Was sich ändert – und was nicht.
Der Werkzeugkasten
Vergröbern
Alter 34 wird zu 30–39, Gemeinde wird zu Kanton. Kein Wert wird falsch – nur ungenauer.
Unterdrücken
Einzelne Zellen werden gelöscht, gezielt dort, wo das Risiko sitzt.
Mikroaggregation
Ähnliche Zeilen werden zu Gruppen zusammengefasst und durch ihren Mittelwert ersetzt.
Rauschen
Auf jeden Wert kommt Zufall. Der Mittelwert bleibt, die Streuung wächst, der Einzelwert verschwindet. Ohne Korrektur werden Zusammenhänge zu schwach.
Vertauschen (Swapping)
Werte werden zwischen Zeilen getauscht – gezielt dort, wo das Risiko sitzt. Für Zensusdaten schlugen Meindl und Templ 2021/22 Targeted Record Swapping vor.
Post-Randomisierung (PRAM)
Kategorien werden innerhalb einer Zeile nach einer offengelegten Übergangsmatrix umkodiert. Kein Wert ist mehr beweisbar echt.
Ziel: maximaler Nutzen unter der Nebenbedingung, dass das Risiko jeder einzelnen Person unter einer Schwelle bleibt. Welche Schwelle das ist, legt das Szenario fest.
Drei Zeilen auf einem österreichischen EU-SILC-Datensatz
# synthetischer EU-SILC-Datensatz für Österreich, 14 827 Personen
sdc <- createSdcObj(eusilc,
        keyVars   = c("age","rb090","db040","pb220a"),
        numVars   = c("py010n","py050n","eqIncome"),
        weightVar = "rb050",
        hhId      = "db030")   # Haushaltsstruktur

sdc <- globalRecode(sdc, "age", breaks = c(0,15,25,35,45,55,65,100))
sdc <- kAnon(sdc, k = 2)
sdc <- microaggregation(sdc)
2-Anonymität – vorher
Nach jedem Schritt werden Risiko und Nutzen automatisch neu berechnet. Genau diese Schleife wird in Teil 5 wieder auftauchen – dann mit einem Sprachmodell darin.
Mit hhId kommt das Haushaltsrisiko dazu: 31.70 vorher, 1.09 nachher. Wer eine Person trifft, hat den Haushalt.
Synthetische Daten
1993
Rubin schlägt synthetische Daten vor – im Journal of Official Statistics.
2014–2017
synthpop und simPop für die amtliche Statistik (CRAN 2014, JSS 2016/17).
2017–2019
GANs erreichen Mikrodaten: medGAN, dann CTGAN.
seit 2023
Sprachmodelle als Generatoren.
Neuer heisst nicht besser: Beim Nutzen liegen synthpop und simPop vorn, die GAN- und VAE-Generatoren und die Transformer darunter.
Drei Sätze zu synthetischen Daten
Synthese verschiebt Information. Sie erschafft keine.
Das Inferenzrisiko verschwindet nicht. Es steckt in genau den Zusammenhängen, die man erhalten will.
Plausibel ist nicht automatisch richtig.
Logikprüfung: Haushalte ohne Erwachsene
Kennzahl NoAdultHH, je Kennzahl skaliert: 1.00 = so sauber wie die Originaldaten.
Nur simPop erreicht die Logik der Originaldaten, synthpop kommt nahe. Was 0.52 konkret heisst: arf erzeugte 1’123’494 Haushalte nur aus Kindern – wahr sind null. Für ein Amt der Ausschlussgrund.
Ein Angriff auf synthetische Daten
- Ein Vorhersagemodell – hier ein Random Forest – wird ausschliesslich auf den synthetischen Daten trainiert.
- Dann sagt er den Gesundheitsstatus realer Personen voraus – von Personen, die er nie gesehen hat.
- Es gibt keine 1:1-Zuordnung mehr. Die Abhängigkeiten zwischen den Merkmalen bleiben aber – und genau die will man ja erhalten.
Und die ehrliche Frage dazu: Was davon ist Offenlegung – und was einfach Statistik, die jedes Modell auf beliebigen echten Daten auch könnte?
Genau dieses Risiko misst RAPID – ein Inferenzrisiko-Mass im CRAN-Paket riskutility: es simuliert den Angreifer als Vorhersagemodell und rechnet gegen die Grundrate auf.
Zugang statt Anonymisierung?
Ein kurzer Blick auf das Mikrodatenzentrum – und warum das die Frage nicht erledigt.
Fünf Wege, mit Personendaten umzugehen
1 · Public Use
Stark anonymisiert, für alle.
2 · Scientific Use
Weniger vergröbert, mit Vertrag.
3 · Sicherer Raum
Vor Ort, unter Aufsicht.
4 · Fernzugriff
Rechnen in einer gesicherten Umgebung, mit Outputkontrolle.
5 · Rechnen ohne Einblick
Privacy-Preserving Computing. Die Auswertung geht zu den Daten. Niemand sieht eine Zeile.
1 → 5: mehr Information in den Daten – weniger Augen darauf. Auf Stufe 5 keine.
Geschützt: die Eingabe. Nicht die Ausgabe.
Quer dazu: synthetische Daten. Keine Stufe, sondern ein Werkzeug auf jeder.
Als Public-Use-Datei · zum Vorbereiten des Codes für Stufe 4.
Das Austrian Micro Data Center
Seit 1. Juli 2022
- Rechtsgrundlage: § 31 Abs. 3–16 BStatG 2000, 2021 eingefügt.
- Zugang nur für akkreditierte wissenschaftliche Einrichtungen: 87, mit 78 laufenden und 24 abgeschlossenen Projekten.
- Gerechnet wird in einer virtuellen Desktop-Infrastruktur: Zwei-Faktor-Authentifizierung, volle Protokollierung, abschliessbarer Raum, am Ende Outputkontrolle.
Outputregeln: mindestens 10 Einheiten je Aggregat, Dominanzregel (2, 80 %).
Was dort nicht passiert
Die Mikrodaten im AMDC sind nicht anonymisiert. Der gesetzliche Massstab ist ein niedrigerer: keine Identifikation
«durch Namen, Anschrift oder anhand einer öffentlich
zugänglichen Identifikationsnummer»
§ 31 Abs. 4 BStatG
Statistik Austria selbst spricht von «potentiell indirekt identifizierbaren» Daten und, für die Forschungsphase, von Pseudonymisierung. Verknüpft wird über ein bereichsspezifisches Personenkennzeichen.
Schutz im Zugang, nicht in den Daten. Bewertet wird nicht die Datei, sondern wer hineindarf und was herauskommt.
Angreiferkosten und agentische KI.
«So viel Aufwand betreibt doch niemand.» – die stille Annahme vom Anfang, jetzt mit Zahlen.
Aus der Verpflichtungserklärung, die Forschende im AMDC unterschreiben:
«… dass ich keine sonstigen Medien und Informationsquellen während des Zugangs nutze.»
Diese Regel schützt den Raum, und das tut sie weiterhin. Sie greift aber nur dort: nicht beim geprüften Output, der hinausgeht, und nicht bei den Dateien, die nie in ein Mikrodatenzentrum kommen – Scientific-Use-Files, offene Daten, beim Broker gekaufte Bewegungsspuren.
Der Flaschenhals war nie die Eindeutigkeit
Neu ist nicht das Risiko. Neu ist, wer die Arbeit macht.
Eindeutigkeit: seit über zehn Jahren belegt. · Was schützte: der Aufwand – geschulte Handarbeit, pro Person.
Agentische KI sitzt inzwischen an beiden Enden des Tisches
Als Angreifer
Sucht selbstständig im Web, kombiniert Register, soziale Netzwerke und Verzeichnisse, prüft die Evidenz und benennt eine Person.
Ohne Aufsicht, viele Ziele parallel. Und das Fachwissen muss nicht mehr beim Angreifer sitzen: es steckt im Modell und in dem Kontext, den man ihm mitgibt.
Als Verteidiger
Schlägt Anonymisierungsstrategien vor, führt sie aus, misst den Informationsverlust unter der k-Schranke und bessert nach.
Sieht dabei nie eine Datenzeile – nur Variablennamen, Typen und aggregierte Risikozahlen. Unterschreiben muss ein Mensch.
Beide Rollen laufen auf demselben Modell. Getrennt werden sie durch das, was es sehen darf.
43 Bewegungsprofile, ein Agententeam, nur öffentliche Quellen
- 43 Freiwillige in der Schweiz, mit ausdrücklicher Einwilligung.
- GPS-Spuren über drei Wochen, simuliert um die echten Wohn- und Arbeitsadressen. Freizeitstopps sind erfundenes Rauschen.
- Der Angreifer erhält eine Gerätespur – so, wie man sie bei einem Datenbroker kauft.
- Erlaubt sind nur frei zugängliche Webquellen. Keine Fake-Profile, kein Social Engineering, keine Täuschung.
- Als Treffer zählt nur ein einziger, richtiger Name – von Hand gegen die Angaben aus der Einwilligung geprüft. Nur der Haushalt zählt nicht.
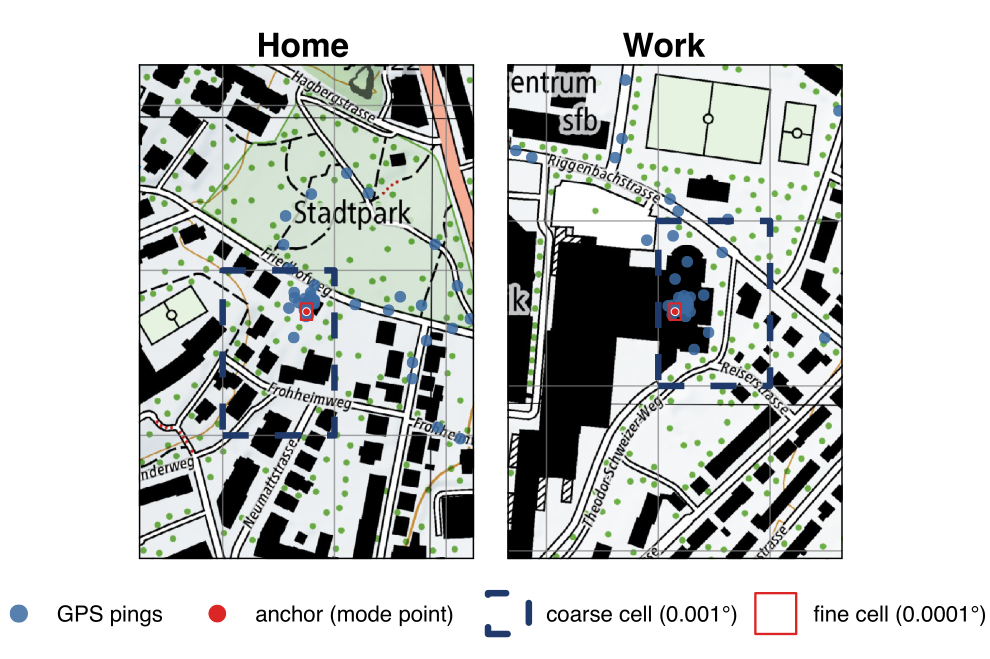
Das Raster verdichtet die Pings zuerst grob (rund 111 × 76 m), dann fein (rund 11 × 7,6 m) – und trifft damit das Gebäude.
Sieben Spezialagenten, sieben Schranken
Der Schlüssel ist der vierte Schritt: das Gebäude- und Wohnungsregister entscheidet, ob eine Adresse überhaupt auf eine Person führt. Ein Produkt der amtlichen Statistik ist hier das entscheidende Angriffswerkzeug.
18 von 25 namentlich identifiziert
| Name genannt | nur Haushalt | kein Kandidat | Summe | |
|---|---|---|---|---|
| tatsächlich identifizierbar | 18 | 2 | 5 | 25 |
| nur Haushalt identifizierbar | 0 | 2 | 0 | 2 |
| nicht identifizierbar | 1 | 1 | 14 | 16 |
| Summe | 19 | 5 | 19 | 43 |
Was den Erfolg treibt: ein Eintrag im öffentlichen Einwohnerverzeichnis, ein Einfamilienhaus, ein nachprüfbarer Arbeitsort.
Was kostet ein Angriff heute?
Und in grossem Massstab?
Alle 43 Läufe an einem Tag, vierfach parallel. Hochgerechnet: 10 000 Ziele für rund 22 400 $.
Eigene Hochrechnung. Zugriffssperren bei dieser Grössenordnung sind nicht gemessen. Mit offenen Modellen auf eigener Hardware sinkt der Preis weiter: eher eine Ober- als eine Untergrenze.
Ehrlich bleiben
Es wurde kein Vergleich mit einem menschlichen Ermittler gemessen. Der Vorteil ist nicht das Tempo im Einzelfall, sondern: billig, parallel, ohne Menschen.
KI als Verteidiger
Weniger als 1 % der Schlüsselzellen unterdrückt, die besetzten Ausprägungen gehen um weniger als 3 % zurück.
Mit GPT-5.5 gut zwei Minuten – dort halbiert die Rückkopplung den Informationsverlust gegenüber fünf unabhängigen Vorschlägen (k = 3).
Die ehrliche Grenze
Lokales 8-Mrd.-Modell: Variablen einordnen – ja, 15 von 15. Anonymisieren – nein, 0 von 30.
Gescheitert ist die Ausführung: Die Schleife nimmt nur gültige Werkzeugaufrufe an. Ob die Vorschläge inhaltlich taugten, wurde nicht gemessen.
Woran wir gerade arbeiten
Längsschnitt- und Ereignisdaten
Mobilität · Ereignisdaten ·
klinische Studien.
Jede weitere Welle: eindeutiger.
Risiko über Record Linkage
Probabilistisch, bayesianisch ·
distanzbasiert.
Für Längsschnitte bisher kein brauchbares Mass.
Synthetische Bevölkerung im Verkehr
SynPop-Datensatz.
Verkehrsmodelle ohne echte Wege.
Risiko bei fehlenden Werten
NA im Schlüssel passt
überall.
Häufigkeit mehrdeutig → über den rekonstruierenden
Angreifer.
Optimale lokale Unterdrückung
kAnon(): heute heuristisch,
künftig exakt
– über gemischt-ganzzahlige lineare Programme
(MILP).
Weiter an beidem:
KI-gestützte
Angriffe · KI als Anonymisierer.
Fünf Sätze zum Mitnehmen
- Risiko ist keine Eigenschaft eines Datensatzes, sondern eines Szenarios.
- Jedes Szenario hat einen Preis – und dieser Preis ist auf 2 Dollar (zu Listenpreisen) und 17 Minuten gefallen.
- Risiko und Nutzen sind beide mehrdimensional. Je eine Zahl versteckt die Schwäche, auf die es ankommt.
- Synthetische Daten verschieben das Risiko. Sie beseitigen es nicht.
- Dieselbe KI, die angreift, kann verteidigen – mit Datenschutz-Firewall und Mensch am Schluss.
Danke.
Fragen?
FHNW School of Business (ICC), Olten · swissanon.com
Thees, Müller & Templ (2026): Agentic AI-powered re-identification. Privacy in Statistical Databases, Springer LNCS, angenommen
Templ (2026): sdcMicro – AI-assisted statistical disclosure control. SoftwareX, in Begutachtung
Templ, Thees & Müller (2026): RAPID. arXiv:2602.09235 · R-Paket riskutility auf CRAN
Literatur
Grundlagen und fremde Arbeiten
- Benedetti, R., Franconi, L. (1998): Statistical and technological solutions for controlled data dissemination. NTTS, Sorrento.
- de Montjoye, Y.-A. et al. (2013): Unique in the crowd. Scientific Reports 3, 1376.
- Domingo-Ferrer, J., Torra, V. (2008): A critique of k-anonymity and some of its enhancements. ARES, 990–993.
- Duncan, G. T., Keller-McNulty, S. A., Stokes, S. L. (2001): Disclosure risk vs data utility. NISS Technical Report 121.
- Dwork, C. (2006): Differential privacy. ICALP, 1–12.
- Farzanehfar, A., Houssiau, F., de Montjoye, Y.-A. (2021): The risk of re-identification remains high even in country-scale location datasets. Patterns 2(3), 100204.
- Golle, P. (2006): Revisiting the uniqueness of simple demographics in the US population. WPES.
- Krumm, J. (2007): Inference attacks on location tracks. Pervasive, LNCS, 127–143.
- Machanavajjhala, A. et al. (2007): l-Diversity. ACM TKDD 1(1), Art. 3.
- Mühlhoff, R. (2021): Predictive privacy. Ethics and Information Technology 23.
- Nowok, B., Raab, G. M., Dibben, C. (2016): synthpop. Journal of Statistical Software 74(11).
- Ronning, G. et al. (2005): Handbuch zur Anonymisierung wirtschaftsstatistischer Mikrodaten. Statistik und Wissenschaft 4, Statistisches Bundesamt.
- Rubin, D. B. (1993): Statistical disclosure limitation. Journal of Official Statistics 9(2), 461–468.
- Staab, R. et al. (2024): Beyond memorization. ICLR, arXiv:2310.07298.
- Sweeney, L. (2000): Simple demographics often identify people uniquely. Carnegie Mellon, Data Privacy Working Paper 3.
- Sweeney, L. (2002): k-Anonymity. Int. J. Uncertainty, Fuzziness and Knowledge-Based Systems 10(5), 557–570.
Eigene Arbeiten
- Templ, M. (2017): Statistical Disclosure Control for Microdata – Methods and Applications in R. Springer, Cham.
- Templ, M., Kowarik, A., Meindl, B. (2015): sdcMicro. Journal of Statistical Software 67(4).
- Templ, M., Meindl, B., Kowarik, A., Dupriez, O. (2017): simPop. Journal of Statistical Software 79(10).
- Thees, O., Novák, J., Templ, M. (2024): Evaluation of synthetic data generators on complex tabular data. PSD, LNCS, 194–209.
- Thees, O., Müller, R., Templ, M. (2026): Beyond the trade-off curve. Journal of Official Statistics, angenommen. arXiv:2510.23500.
- Thees, O., Müller, R., Templ, M. (2026): Agentic AI-powered re-identification. PSD, Springer LNCS, angenommen.
- Templ, M., Thees, O., Müller, R. (2026): RAPID. arXiv:2602.09235.
- Templ, M. (2026): sdcMicro – AI-assisted statistical disclosure control of microdata in R. SoftwareX, in Begutachtung.
Rechtsgrundlagen und Software
- DSGVO (EU) 2016/679, Erwägungsgrund 26.
- Bundesstatistikgesetz (Deutschland), § 16 Abs. 6.
- Bundesstatistikgesetz 2000 (Österreich), § 31 Abs. 3–16.
- R-Pakete auf CRAN: sdcMicro, simPop, laeken, riskutility.
Fragen, die erfahrungsgemäss kommen.
Fünf Risiko- und fünf Nutzenkennzahlen messen Verschiedenes
Risiko
- RepU – wurden echte Zeilen reproduziert?
- TCAP – lässt sich ein sensibles Merkmal zuordnen?
- RAPID – wie viel Inferenz erlaubt die Freigabe?
- MIA – lässt sich die Teilnahme erkennen?
- DCR – wie nah liegen synthetische an echten Zeilen?
Nutzen
- pMSE – sind echt und synthetisch unterscheidbar?
- CIProx – stimmen die Konfidenzintervalle?
- Wasserstein – stimmen die Verteilungen?
- CMD – bleibt die Korrelationsstruktur erhalten?
- NoAdultHH – sind die Daten logisch möglich?
5 × 5 = 25 Karten, wenn man alle Paare zeigen will.
Oder ein Mittelwert – in dem die eine kritische Schwäche verschwindet.
Hängt die Pareto-Front nicht von der Skalierung ab?
Ja und nein – und der Unterschied ist der Punkt. Die multivariate Front ist skalierungsinvariant: monotone Transformationen je Kennzahl ändern keine Dominanzbeziehung. Skalierungsabhängig ist erst die zusammengefasste Karte.
| Skalierung | Pareto-optimal auf der zusammengefassten Karte |
|---|---|
| roh | Verfahren 3, Verfahren 4 |
| Min-Max | Verfahren 2, Verfahren 3, Verfahren 4 |
| z-Standardisierung | Verfahren 2, Verfahren 3 |
Das Paper sagt es selbst: die Dominanz wird auf den zusammengefassten Werten ausgewertet, nicht auf den rohen Vektoren. Deshalb gehört die gewählte Standardisierung in jeden Bericht – und deshalb keine Risikoschwelle auf eine zusammengesetzte Achse, sondern auf die Achse der einzelnen Kennzahl.
Wie belastbar ist das Angriffsexperiment?
Grenzen, die das Paper selbst nennt
- n = 43, nur Schweiz, nur ein Spurengenerator.
- Jeder Fall einmal gelaufen – keine Streuung gemessen.
- Keine Baseline gegen einen menschlichen Ermittler und kein Vergleich mit einer nicht-agentischen Lösung.
- Ergebnisse gelten unter den Sicherheitsfiltern eines kommerziellen Spitzenmodells.
Was es trotzdem zeigt
Es ist eine Machbarkeitsstudie, keine Bevölkerungsschätzung. Aber für die Frage, ob eine Re-Identifikation «nach allgemeinem Ermessen wahrscheinlich» ist, genügt der Nachweis, dass sie billig gelingt und im Betrieb keinen Menschen mehr braucht.
Was als Nächstes billiger wird
Modelle, die zu Hause laufen
- Offene Modelle auf handelsüblicher Hardware senken den Kostenboden weiter.
- Ohne Aufruf bei einem Anbieter gibt es kein Protokoll, in dem so ein Lauf auffällt – und keinen Zugang, den jemand sperren könnte.
- Und keine Sicherheitsfilter des Anbieters.
Agenten, die Kontakt aufnehmen
- Anrufe, E-Mails, gefälschte Profile.
- Geolokalisierung aus Fotos, Gesichtserkennung, Personensuchdienste.
- Technisch heute möglich – in dieser Studie bewusst nicht getan.
Das sind Skizzen, keine Messungen. Aber die Richtung ist eindeutig: die Zahlen von vorhin sind eher eine Obergrenze der Kosten als eine Untergrenze.
Warum kommt Differential Privacy nicht vor?
Was sie leistet
Eine beweisbare Schranke: Ob eine einzelne Person in den Daten ist oder nicht, darf das Ergebnis nur um den Faktor eε verändern.
Damit ist sie das einzige Verfahren hier, das ohne Annahme über den Angreifer auskommt – und deshalb gegen die Kostenfrage immun.
Warum sie hier trotzdem fehlt
- Sie beantwortet eine andere Frage: nicht «wie riskant ist diese Datei», sondern «was kostet diese Auswertung an Budget».
- Für ganze Mikrodatensätze mit brauchbarem ε ist sie in der amtlichen Statistik bis heute die Ausnahme.
- Und sie löst das Inferenzproblem nicht, sie definiert es weg: Was aus der Population lernbar ist, gilt nicht als Schaden.
Genau dort trennen sich Dwork und Mühlhoff – und dort liegt das Inferenzrisiko aus Teil 3.
Was sollte die amtliche Statistik jetzt tun?
- Risikomodelle formulieren, die agentische Angreifer explizit einpreisen – nicht den Menschen mit dem Telefonbuch.
- Verfahren mit formalen Garantien bevorzugen, wo der Kostenvorteil eines Angriffs gross ist.
- Bei Rohdaten mit Raum-Zeit-Bezug: abgestufte Zugangsregime statt Public Use.
- Öffentliche Register als Angriffsfläche mitdenken. Sie sind heute der wirksamste Hebel des Angreifers.
- Und: die eigenen Freigaben selbst angreifen, bevor es andere tun.
Der Aufruf des Papers wörtlich: die SDC-Gemeinschaft solle agentische KI-Angreifer als reale und nicht als hypothetische Bedrohung behandeln.
Die Abbildung aus dem Paper
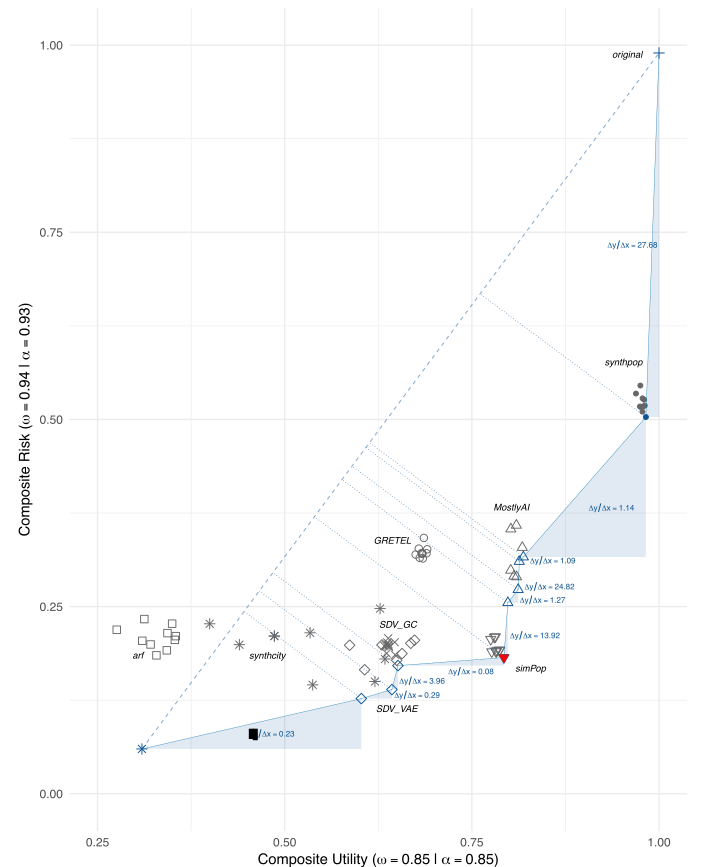
Was hier anders ist als auf Folie 16
Gezeichnet sind Einzelreplikate, nicht Mittelwerte, und die Achsen sind gewichtete Composites (ω, α) statt einfacher Mittel. Die Front und das Knie fallen gleich aus.
Die Steigungen an der Front
Jede Zahl an der Front ist ΔRisiko / ΔNutzen. Der letzte Schritt zum Original: 27.68 hier, 19.5 auf den einfachen Mitteln von Folie 16.